PDF w Google: jak Google go czyta, czego nie widzi i skąd fala wyindeksowań w 2026
Google czyta PDF jak stronę HTML, ale skanu bez warstwy tekstu może nie odczytać, a nowy cennik pod starą nazwą pliku potrafi długo czekać na odświeżenie. Co mówią o tym ludzie z Google i jak ustawić pliki.
Translated from Polish. Facts and examples refer to the Polish market.
Spis treści
- Krótka odpowiedź
- Jak Google czyta PDF: konwerter zamiast przeglądarki
- Czego Google w PDF nie widzi
- Nowy cennik pod starą nazwą pliku: dlaczego Google pokazuje stary
- Fala wyindeksowań PDF w 2026 roku
- Jak sprawdzić, które PDF-y wypadły z indeksu
- Jak ustawić PDF: noindex, canonical, metadane
- Cennik, katalog, karta produktu: HTML czy PDF
Cenniki, katalogi i karty produktów w PDF zniknęły z Google albo pokazują stare dane?
Co obejmuje audyt SEO i GEOKrótka odpowiedź
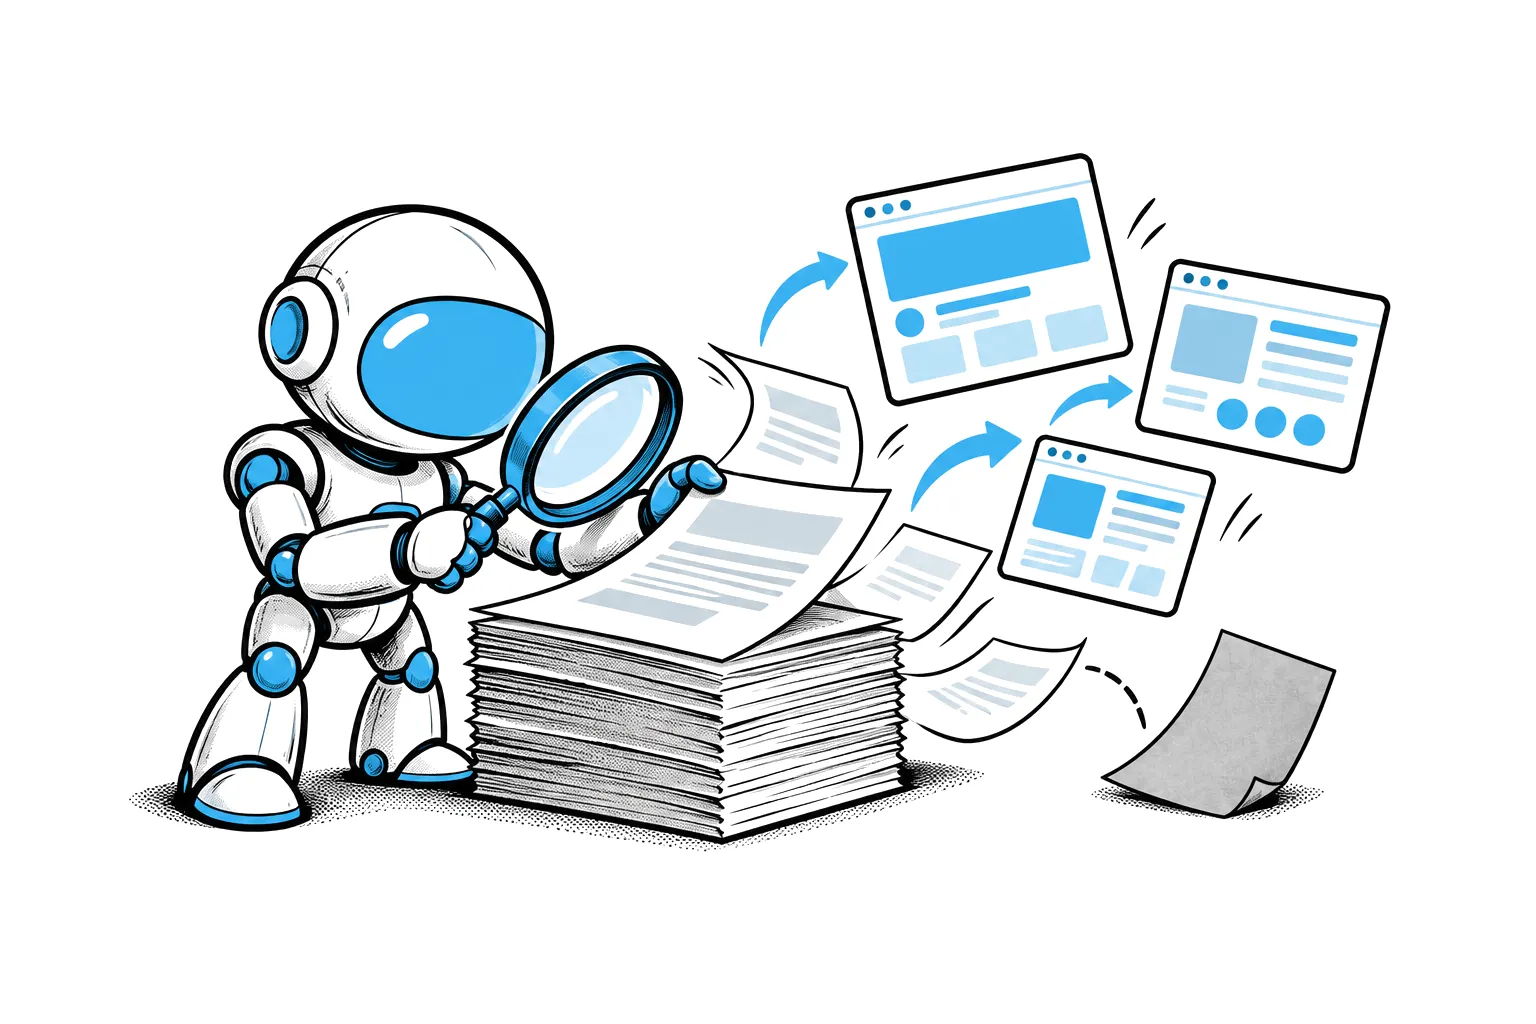
Google nie czyta PDF-a tak jak Ty w przeglądarce. Zamienia plik na zwykłą stronę HTML i dalej ocenia go tak jak każdą inną stronę, także w przeglądzie od AI i trybie AI. Tak opisali to Martin Splitt i John Mueller z Google w podcaście Search Off the Record 13 października 2026 roku.
Z tego wynikają trzy praktyczne rzeczy. Skanu bez warstwy tekstu Google może nie odczytać. Obrazy w PDF prawdopodobnie nie trafiają do grafiki Google, choć Martin Splitt zastrzegł, że to mogło się już zmienić. A poprawiony cennik wgrany pod tę samą nazwę pliku może długo wisieć w Google w starej wersji, bo PDF-y Google pobiera ponownie rzadko. Do tego od końca sierpnia 2026 roku wiele serwisów zobaczyło, jak ich PDF-y masowo wypadają z indeksu.
Jak Google czyta PDF: konwerter zamiast przeglądarki
Martin Splitt powiedział wprost: „we are not using a PDF viewer”. Google ma komponent nazywany konwerterem, który działa w czasie indeksowania, zaraz po renderowaniu i tuż przed dodaniem dokumentu do indeksu. Konwerter robi z PDF-a wersję HTML, możliwie wierną oryginałowi, bo reszta systemów Google pracuje prawie wyłącznie na HTML. Podobne konwertery Google ma dla dokumentów tekstowych, plików RTF i arkuszy Excel.
Skutki są proste:
- Linki w PDF działają. Po konwersji zostają w wersji HTML, więc Google je widzi.
- Ranking działa prawie tak samo. Splitt: indeksowanie i ranking są „pretty much the same as any other document”.
- PDF może pojawić się w odpowiedziach AI. Mueller powiedział, że pliki PDF mogą trafić do przeglądu od AI i trybu AI, a Splitt potwierdził: Google nie obchodzi, czy dokument był oryginalnie PDF-em.
Pobranie pliku
Googlebot pobiera pierwsze 64 MB pliku PDF.
- zatrzymuje: blokada w robots.txt
Konwerter
Po renderowaniu, przed indeksem, Google zamienia PDF na stronę HTML.
- utrudnia: skan bez warstwy tekstu
- zatrzymuje: hasło na pliku
- obrazy w pliku nie mają własnego adresu
Indeks i ranking
Dalej plik jest traktowany jak każda strona HTML.
- linki z pliku zostają
- zatrzymuje: X-Robots-Tag: noindex
Wyniki
Zwykłe wyniki, przegląd od AI i tryb AI.
- zmieniony plik pod starym adresem Google odświeża rzadko
Jedno zastrzeżenie dotyczy długich plików. Mueller porównał całą książkę w jednym PDF do książki wklejonej na jedną stronę HTML: Google trudno ustalić, dla którego fragmentu taki dokument ma się pokazywać. Nasz wniosek dla firm: przy stu produktach w jednym pliku Google trudniej ustalić, dla którego produktu plik ma się pokazywać, więc lepiej dać każdemu produktowi osobną stronę.
Czego Google w PDF nie widzi
Skany bez warstwy tekstu
Splitt nazwał to najgorszym problemem PDF-ów. Jeśli strony pliku są obrazami, na przykład zeskanowany cennik albo karta katalogowa od producenta zapisana jako grafika, Google może nie zobaczyć w nich treści. Mueller dodał, że niektóre systemy mogą umieć rozpoznać tekst na obrazie, ale nie można na tym polegać.
Łatwo to sprawdzić. Otwórz PDF, zaznacz cały tekst skrótem Ctrl+A (na Macu Cmd+A), skopiuj i wklej do pustego pliku tekstowego. Jeśli tekst się pojawił, nie jest zamknięty w obrazie i Google powinien go odczytać. Jeśli nie ma nic, Google według Splitta nie zobaczy treści pliku i trzeba go wygenerować ponownie z dokumentu źródłowego albo przepuścić przez program z rozpoznawaniem tekstu.
Obrazy w środku pliku
Grafika Google dostaje obrazy po ich adresach. Obraz osadzony w PDF własnego adresu nie ma. Splitt powiedział, że Google prawdopodobnie wie o obrazie, ale nie sądzi, żeby przetwarzał go jak zwykłe zdjęcie w wyszukiwarce grafiki. Zastrzegł, że to jego obecna wiedza i może się zmienić. Jeśli zdjęcia produktów mają być widoczne w grafice Google, opublikuj je też jako zwykłe obrazy na stronie, na przykład na stronie produktu.
Pliki z hasłem i zablokowane
Plik chroniony hasłem jest dla Google nieczytelny. Tak samo plik zablokowany w robots.txt, bo robot go nie pobierze.
Treść ponad limitem rozmiaru
W podcaście Splitt przyznał, że nie zna limitu dla PDF. Dokumentacja Googlebota go podaje: Google pobiera pierwsze 64 MB pliku PDF, a z pozostałych obsługiwanych plików, w tym HTML, pierwsze 2 MB. Treść poza tym limitem jest pomijana. Zwykły cennik czy karta produktu mieszczą się z dużym zapasem. Problem mogą mieć ciężkie katalogi z wieloma zdjęciami w wysokiej rozdzielczości.
Nowy cennik pod starą nazwą pliku: dlaczego Google pokazuje stary
To zachowanie najbardziej dotyka firm, które co kwartał wgrywają nowy cennik albo katalog pod tym samym adresem, na przykład /pliki/cennik.pdf. Mueller wyjaśnił, że Google traktuje PDF trochę jak obraz: zakłada, że plik długo się nie zmieni, więc nie pobiera go ponownie co chwilę. Nowa wersja może więc długo czekać na odświeżenie w Google, a klient z wyników może zobaczyć w opisie stare ceny.
Rada Muellera z podcastu: przy zmianie treści użyj nowej nazwy pliku. Google znajdzie link do nowego adresu, rozpozna, że to nowy adres, i spróbuje go pobrać i zaindeksować. W praktyce:
- Zapisz nową wersję pod nazwą z datą albo okresem, na przykład
cennik-2026-q4.pdf. - Zmień linki na stronie i w mapie witryny na nowy adres.
- Stary adres przekieruj na nowy przekierowaniem 301 albo usuń. To nasza rekomendacja: klient z dawnego linku nie trafi wtedy na nieaktualne ceny.
Martin Splitt dorzucił drugą wskazówkę: ustaw nagłówki pamięci podręcznej zgodnie z rytmem zmian. Katalog zmieniany co kwartał może być w pamięci podręcznej przez kilka miesięcy.
Mueller przypomniał też pułapkę z dawnych lat: jeden z systemów CMS (nie pamiętał który, może Joomla) dawał przy każdej stronie jej wersję PDF do druku. Google odświeża PDF rzadziej, więc w indeksie potrafi wisieć stara treść w PDF i nowa w HTML, a obie wersje konkurują o to samo zapytanie. Jego rada: treści, które często się zmieniają, w PDF najlepiej wyłączyć z indeksowania. Ogólne tempo, w jakim Google zauważa zmiany, opisujemy w tekście ile Google potrzebuje na zaindeksowanie zmian.
Fala wyindeksowań PDF w 2026 roku
Pod koniec sierpnia 2026 roku specjaliści SEO zaczęli zgłaszać gwałtowne spadki kliknięć w pliki PDF. Barry Schwartz opisał to w Search Engine Roundtable 25 sierpnia. Pierwszy sygnał dała na LinkedInie Savanna Gray, a Lily Ray pisała, że PDF-y wypadają z indeksu. Schwartz zauważył, że dla formularzy amerykańskiego urzędu skarbowego IRS, takich jak W-9 i W-4, Google zamiast pliku PDF z urzędu pokazywał stronę HTML urzędu albo serwisy innych firm. Tego samego dnia Lily Ray zauważyła, że cała witryna IRS była dla niej niedostępna, więc ten przypadek mógł mieć inną przyczynę. John Mueller odpisał tylko, że sprawdzi. Dwa dni później PDF-y IRS wróciły na szczyt. Barry Schwartz uznał, że Google może wdrażać poprawkę, ale Google tego nie potwierdził.
Glenn Gabe z GSQI opisał 16 września, że problem był szerszy. W Search Console pliki przechodziły do statusu „Strona zeskanowana, ale jeszcze niezindeksowana”, a w jednym z serwisów kliknięcia i wyświetlenia PDF spadły około 25 sierpnia. Gabe ocenił, że skala wskazuje na zmianę w systemach Google. Część serwisów odzyskała już widoczność: pliki wracały do indeksu.
Stan na 29 października 2026 roku: nie znaleźliśmy wyjaśnienia przyczyny od Google, a w podcaście o PDF z 13 października nie było o tym mowy. Nie wiadomo, czy wszystkie pliki wróciły. Jeśli Twoje cenniki, katalogi czy karty produktów przyciągały klientów z Google, sprawdź ich status.
Jak sprawdzić, które PDF-y wypadły z indeksu
Metoda Glenna Gabe’a w wersji dla mniejszego serwisu:
- W Search Console otwórz raport skuteczności, dodaj filtr strony z wyrażeniem regularnym
\.pdf$(jeśli adresy plików mają parametry, na przykład?v=2, użyj\.pdfbez znaku $) i porównaj lipiec 2026 z ostatnimi tygodniami. Raport pokazuje do 1 000 wierszy, co przy mniejszej liczbie plików wystarczy. - Pliki, które straciły wyświetlenia, sprawdź pojedynczo w narzędziu do sprawdzania adresów URL. Status indeksowania pokaże, czy PDF jest w indeksie.
- Przy setkach i tysiącach plików użyj URL Inspection API. Gabe robił to dodatkiem Analytics Edge do Excela: lista PDF z API wyników, potem sprawdzenie każdego adresu i filtr według statusu.
API ma limit 2 000 sprawdzeń dziennie i 600 na minutę w jednej usłudze. Gabe zwraca uwagę, że każda usługa ma osobny limit, więc dodatkowe usługi dla katalogów, na przykład https://example.com/pliki/, zwiększają dzienną pulę. Szczegóły tego i innych ograniczeń są w tekście limity Search Console i jak je obejść.
Jak ustawić PDF: noindex, canonical, metadane
Wyłączenie PDF z indeksu: X-Robots-Tag
W PDF nie wstawisz meta tagu robots. Google zaleca nagłówek HTTP X-Robots-Tag. Przykład z dokumentacji dla wszystkich plików PDF w serwisie na serwerze Apache (główny plik .htaccess):
<Files ~ "\.pdf$">
  Header set X-Robots-Tag "noindex, nofollow"
</Files>
Ten sam efekt na NGINX:
location ~* \.pdf$ {
  add_header X-Robots-Tag "noindex, nofollow";
}
Nie blokuj przy tym plików w robots.txt. Google musi pobrać plik, żeby zobaczyć nagłówek. Gdy dostęp jest zablokowany, noindex do niego nie dotrze.
Wskazanie głównej wersji dokumentu: canonical w nagłówku
Mueller zauważył, że skopiowany PDF to dla Google identyczny plik na innej stronie, więc trudniej ustalić, który adres jest oryginałem. Dotyczy to na przykład kart technicznych producenta, które publikuje każdy sprzedawca. Element link rel="canonical" działa tylko w HTML, dlatego dla PDF Google przewiduje nagłówek odpowiedzi serwera:
Link: <https://example.com/pliki/karta-produktu.pdf>; rel="canonical"Adres musi być pełny. Google obsługuje ten nagłówek tylko w zwykłych wynikach wyszukiwania. Więcej o tym, kiedy Google słucha takiej wskazówki, piszemy w tekście jak działa link kanoniczny.
Metadane i link do strony
Splitt radzi wypełnić metadane PDF: autora, opis i link do źródła. Mueller dodaje prosty sposób: w nagłówku dokumentu umieść zwykły link do swojej strony. Konwerter go zachowa, więc nawet kopia pliku na cudzym serwerze poprowadzi klienta do Ciebie.
Cennik, katalog, karta produktu: HTML czy PDF
Splitt woli HTML, ale uważa, że PDF ma sens, gdy treść tego wymaga: dokładny wygląd po wydruku, formularz do wypełnienia. Menu restauracji w PDF jest według niego lepsze niż brak menu na stronie. Mueller dodaje, że jeśli treść da się łatwo przenieść do HTML, wszystko jest prostsze. Na tej podstawie proponujemy:
- Cennik zmieniany kilka razy w roku: ceny na zwykłej stronie, PDF tylko do pobrania. Jeśli PDF powtarza treść strony, rozważ dla niego noindex, żeby rzadziej odświeżana kopia nie konkurowała z aktualną stroną.
- Katalog produktów: każdy produkt na osobnej stronie, cały katalog w PDF do druku. Klient z Google trafia wtedy na konkretny produkt, a Google łatwiej ustalić, czego dotyczy strona z jednym produktem.
- Karta techniczna lub instrukcja: najważniejsze parametry na stronie produktu, pełny PDF obok. Jeśli publikujesz kartę producenta, dodaj link do swojej strony w treści pliku.
- Formularz, regulamin do podpisu, dokument do druku: PDF jest w porządku, pod warunkiem że przejdzie test kopiowania tekstu.
Jeśli w Twoim serwisie są setki plików PDF i nie wiesz, które z nich wypadły z Google ani które warto zamienić na strony, sprawdzimy to w ramach audytu SEO i GEO.
Kiedy potrzebny jest specjalista
Cenniki, katalogi i karty produktów w PDF zniknęły z Google albo pokazują stare dane? W audycie sprawdzamy status plików, nagłówki i to, które warto zamienić na strony.
Co obejmuje audyt SEO i GEONajczęstsze pytania
Czy Google indeksuje pliki PDF?
Tak. Google zamienia PDF na stronę HTML i dalej indeksuje go jak każdą inną stronę. Najpewniej wtedy, gdy w pliku jest tekst, który da się zaznaczyć i skopiować.
Czy PDF może pojawić się w przeglądzie od AI?
Tak. John Mueller z Google potwierdził w podcaście z 13.10.2026, że pliki PDF mogą pojawiać się w przeglądzie od AI i trybie AI, bo po konwersji są dla Google zwykłą stroną.
Dlaczego Google pokazuje starą wersję mojego PDF?
Google pobiera pliki PDF ponownie rzadko, bo zakłada, że się nie zmieniają. John Mueller radzi przy zmianie treści zapisać plik pod nową nazwą i zmienić do niego linki.
Jak usunąć PDF z wyników Google?
Ustaw dla pliku nagłówek HTTP X-Robots-Tag: noindex. Nie blokuj go w robots.txt, bo wtedy Google nie pobierze pliku i nie zobaczy nagłówka. Szybkie ukrycie da też narzędzie do usuwania w Search Console.
Czy zeskanowany dokument w PDF będzie widoczny w Google?
Nie można na to liczyć. Skan to obraz strony bez tekstu. Martin Splitt z Google nazwał to najgorszym problemem PDF-ów. Sprawdź to, kopiując tekst z pliku do notatnika.
Ile może ważyć PDF, żeby Google go przeczytał?
Według dokumentacji Googlebot pobiera pierwsze 64 MB pliku PDF. Treść poza tym limitem jest pomijana.
Dlaczego moje PDF-y zniknęły z Google w sierpniu 2026?
Od drugiej połowy sierpnia 2026 wiele serwisów zgłaszało spadki kliknięć w pliki PDF, a Glenn Gabe pokazał, że pliki przechodziły do statusu „Strona zeskanowana, ale jeszcze niezindeksowana”. Część wróciła do indeksu. Wyjaśnienia przyczyny od Google nie znaleźliśmy.
Przeczytaj też
- Sprzeczności w dokumentacji Google: co mówi jedna strona, a co drugaDziesięć miejsc, w których strony Google, polskie tłumaczenia i pracownicy Google mówią co innego albo łatwo je źle odczytać. Cytaty, daty, decyzja.Technika strony i indeksowanie
- Ile trwa indeksowanie w Google: czasy od odkrycia do powrotu po core updateCzasy Google z wystąpienia Gary’ego Illyesa (Barcelona 2026) obok dokumentacji: indeksowanie, przeprowadzka, kara ręczna, core update i kiedy przestać czekać.Technika strony i indeksowanie
- Noindex dla wyników kalkulatorów, konfiguratorów i linków do udostępnieniaGoogle od 26.10.2026 prosi, by wyniki narzędzi i strony do udostępniania domyślnie nie były indeksowane. Których stron to dotyczy i czemu robots.txt nie wystarczy.Technika strony i indeksowanie
Źródła
- Search Off the Record, odc. 115: PDFs in Search (transkrypcja)
- Google Search Central: typy plików indeksowane przez Google
- Google Search Central: metatag robots i X-Robots-Tag
- Google Search Central: rel="canonical" w nagłówku HTTP
- Google Search Central: Googlebot i limity rozmiaru plików
- Search Console API: limity URL Inspection API
- Search Engine Roundtable: Google pokazuje mniej PDF (25.08.2026)
- Glenn Gabe (GSQI): jak znaleźć wyindeksowane PDF (16.09.2026)
- Search Engine Journal: jak Google ocenia PDF